Localization
Để điều khiển xe bám theo một quỹ đạo, trước hết phải biết xe đang ở đâu. Có hai mức: định vị cục bộ (so với cảnh quanh xe) và toàn cục (so với một hệ tọa độ/bản đồ chung). Toàn cục cần cho việc lập kế hoạch đường đi và để tận dụng thông tin bản đồ (biển báo, vạch làn). Bài này điểm qua các cách định vị — GPS, định vị thị giác, định vị theo bản đồ đường — rồi code một ví dụ định vị thị giác (PnP + RANSAC) trên Argoverse, nối thẳng với BA đã dựng ở bài SLAM.
VO cho chuyển động tương đối; SLAM dựng bản đồ và định vị đồng thời. Localization là mảnh cuối: dùng một bản đồ (hoặc GPS, road map, HD map) để tìm pose toàn cục của xe — và phải chạy real-time vì mọi quyết định lái phía sau đều cần vị trí ngay.
Ký hiệu & viết tắt
- GNSS / GPS
- hệ định vị vệ tinh (GPS là hệ của Mỹ). 6DoF = 6 bậc tự do (vị trí 3D + xoay 3D).
- IMU / INS
- cảm biến quán tính (gia tốc + con quay) / hệ dẫn đường quán tính tích phân từ IMU.
- CSDL
- cơ sở dữ liệu (database) các landmark đã dựng sẵn.
- PnP
- Perspective-n-Point: tìm pose camera từ các tương ứng 3D→2D đã biết.
Mục lục
- Định vị vệ tinh (GPS/GNSS)
- Định vị thị giác: 4 hướng
- Ví dụ: feature-based localization bằng PnP trên Argoverse
- Định vị theo bản đồ đường
- Tổng hợp: VO – SLAM – Localization
- Triển khai thực tế: hợp nhất cảm biến
- Xu hướng 2025–2026
Định vị vệ tinh (GPS/GNSS)
Ý tưởng: ta biết vị trí các vệ tinh, đo khoảng cách tới chúng (qua thời gian truyền tín hiệu), rồi giao các mặt cầu để tìm vị trí mình — thường cần 4 vệ tinh (3 cho vị trí, 1 để khử sai lệch đồng hồ thu).
Hai khái niệm quan trọng:
- GDOP (Geometric Dilution of Precision): khi khoảng cách có nhiễu, vị trí các vệ tinh trên trời quan trọng không kém số lượng của chúng. Mỗi khoảng cách đo được là một dải bất định (không phải một mặt cầu mỏng), và vị trí của ta nằm ở chỗ các dải này giao nhau. Vệ tinh trải rộng (góc giao lớn) ⇒ vùng giao nhỏ, gọn ⇒ định vị tốt; vệ tinh chụm cùng một hướng ⇒ góc giao hẹp ⇒ vùng giao kéo dài thành vệt ⇒ bất định lớn. GDOP gói toàn bộ ảnh hưởng hình học này vào một con số.
- DGPS (Differential GPS): một trạm mặt đất đặt ở vị trí đã biết cực chính xác sẽ tự đo sai số GPS của chính nó (vì biết vị trí thật), rồi phát hiệu chỉnh đó cho các máy thu gần đó trừ bớt cùng sai số khí quyển — đẩy độ chính xác từ vài mét xuống vài cm (bản nâng cao là RTK-GNSS).
Hạn chế của GPS:
- Khả dụng — mất tín hiệu trong hầm, phố hẹp (nhà cao che).
- Độ chính xác — vài mét (GPS thô) → vài cm (DGPS/RTK + IMU).
- Chỉ đo vị trí — không có hướng (rotation) trừ khi hợp nhất với IMU.
- Tần số thấp — 5–10 Hz (≈ 0,1–0,2 s/lần) trong khi điều khiển xe cần ~100–1000 Hz.
- Multipath — ở phố nhiều nhà cao, tín hiệu phản xạ qua mặt tường làm thời gian đo sai, vị trí có thể nhảy cả trăm mét.
→ GPS một mình không đủ. Đây là lý do cần định vị thị giác và hợp nhất cảm biến.
Định vị thị giác: 4 hướng
Ý tưởng chung: dựng sẵn một bản đồ (CSDL) gồm các vị trí biết trước kèm đặc trưng (thường là landmark 3D, mỗi cái gắn một vector mô tả ngoại hình, trích từ ảnh hoặc laser khi mapping — ví dụ bằng SLAM). Lúc định vị: lấy đặc trưng từ ảnh/scan hiện tại rồi tra ngược trong CSDL để suy ra pose. Bốn hướng chính:
-
Topometric — thay vì tính pose chính xác, nó hỏi: “khung hình hiện tại giống ảnh nào đã lưu nhất?”. Toàn ảnh được tóm tắt thành một vector toàn cục; ta tìm vector gần nhất trong CSDL rồi trả về frame ID của nó (suy ra pose nơi đã chụp khung hình đó) — chứ không phải pose 6DoF. Bản đồ là đồ thị có hướng, mỗi node là một frame (chỉ thêm node khi xe đã đi quá một ngưỡng khoảng cách, để xe đứng yên không sinh node thừa). Một lọc Bayes rời rạc bám vết vị trí qua thời gian, giúp độ chính xác tốt dần lên.
-
Học sâu — một mạng CNN đoán thẳng ra pose 6DoF (vị trí 3D + xoay 3D) từ một tấm ảnh RGB. Ưu: ít bị rối bởi điểm sai (outlier) hơn cách dùng đặc trưng. Nhược: kém chính xác, pose chỉ gần đúng so với thực tế.
-
Feature-based — nối thẳng với BA. Bản đồ gồm các điểm 3D, mỗi điểm gắn một descriptor (SIFT/SURF/deep). Ảnh truy vấn: trích descriptor → so khớp với CSDL bằng tìm kiếm xấp xỉ nhanh (kd-tree, inverted index, FLANN…) thay vì brute force. Đây là ví dụ ta sẽ code.
-
Map-based — không cần bản đồ đặc trưng dựng sẵn, chỉ cần road map miễn phí (OpenStreetMap) + chuyển động tương đối từ VO.
Ví dụ: feature-based localization bằng PnP trên Argoverse
Feature-based là hướng nối thẳng với BA ở bài SLAM. Khác biệt cốt lõi:
Ở BA, ta tối ưu đồng thời pose camera và điểm 3D. Ở localization, điểm 3D đã cố định (nằm sẵn trong bản đồ) — ta chỉ giải pose. Bài nhỏ hơn nhiều và có lời giải đóng: đó chính là PnP (Perspective-n-Point), tìm
(R, t)tối thiểu hoá reprojection error của các điểm 3D đã biết chiếu vào ảnh.
Hình dung cho dễ: như khi bước vào một căn phòng quen — bạn nhận ra vài đồ vật (các điểm 3D đã biết trong bản đồ), và chỉ từ việc chúng trông ra sao từ chỗ bạn đứng (vị trí 2D trên ảnh), bạn suy ra được mình đang đứng đâu và nhìn về hướng nào. PnP làm đúng việc đó.
Một điểm khác nữa: vì bản đồ khổng lồ và phải dùng tìm kiếm xấp xỉ, rất nhiều khớp bị sai (>50%, có khi >80%). Nên bắt buộc phải geometric verification bằng RANSAC:
- Lấy tập tối thiểu 3 tương ứng (mỗi điểm cho 2 quan sát $x, y$ ⇒ $3\times2 = 6$ = số tham số pose) để giải pose cực nhanh.
- Đếm inlier (chiếu mọi điểm còn lại, xem khớp tốt không) ⇒ điểm số ủng hộ model.
- Lặp lấy mẫu, giữ model tốt nhất, cuối cùng tinh chỉnh chỉ trên inlier.
So với BA thuần (giả định tương ứng đã đúng), RANSAC chính là cơ chế lọc outlier mà BA không có.
Dựng ví dụ trên Argoverse. Bản đồ = các điểm 3D lidar gom về hệ city (như phần mapping ở bài SLAM); query = một ảnh camera đã biết thông số nội $K$ (intrinsic — tiêu cự, tâm ảnh). Ta chiếu bản đồ vào camera để tạo tương ứng 3D(city)→2D(ảnh), rồi cố tình trộn 60% khớp sai (giả lập lỗi của tìm-gần-đúng/ANN search), và để cv2.solvePnPRansac khôi phục pose:
import cv2, numpy as np
# MAP: (N,3) điểm 3D hệ city ; K: intrinsic ; R_gt,t_gt: pose camera GT (city->cam)

# 1) chiếu map vào camera query -> tương ứng 3D->2D (pinhole)
Pc = (R_gt @ MAP.T).T + t_gt                 # map points trong hệ camera
u = K[0,0]*Pc[:,0]/Pc[:,2] + K[0,2]
v = K[1,1]*Pc[:,1]/Pc[:,2] + K[1,2]
vis = (Pc[:,2] > 0.5) & (0 < u) & (u < 1920) & (0 < v) & (v < 1200)
obj, uv = MAP[vis], np.stack([u[vis], v[vis]], 1)        # ~140 điểm khớp đúng
uv += np.random.normal(0, 1.5, uv.shape)                 # nhiễu định vị keypoint

# 2) trộn 60% khớp SAI: điểm 3D thật ghép với pixel ngẫu nhiên (như ANN search nhầm)
obj_all = np.vstack([obj, obj[rng.integers(0, len(obj), 210)]])
uv_all  = np.vstack([uv,  rng.uniform([0,0], [1920,1200], (210,2))])

# 3) PnP + RANSAC: điểm 3D cố định, chỉ giải pose
ok, rvec, tvec, inliers = cv2.solvePnPRansac(
    obj_all, uv_all, K, None, reprojectionError=3.0, flags=cv2.SOLVEPNP_EPNP)
C_est = -cv2.Rodrigues(rvec)[0].T @ tvec.ravel()         # tâm camera trong hệ city
# 350 match (60% sai) -> RANSAC giữ 89 inlier, precision 100%
# sai số vị trí = 0.03 m ; sai số xoay = 0.10 deg
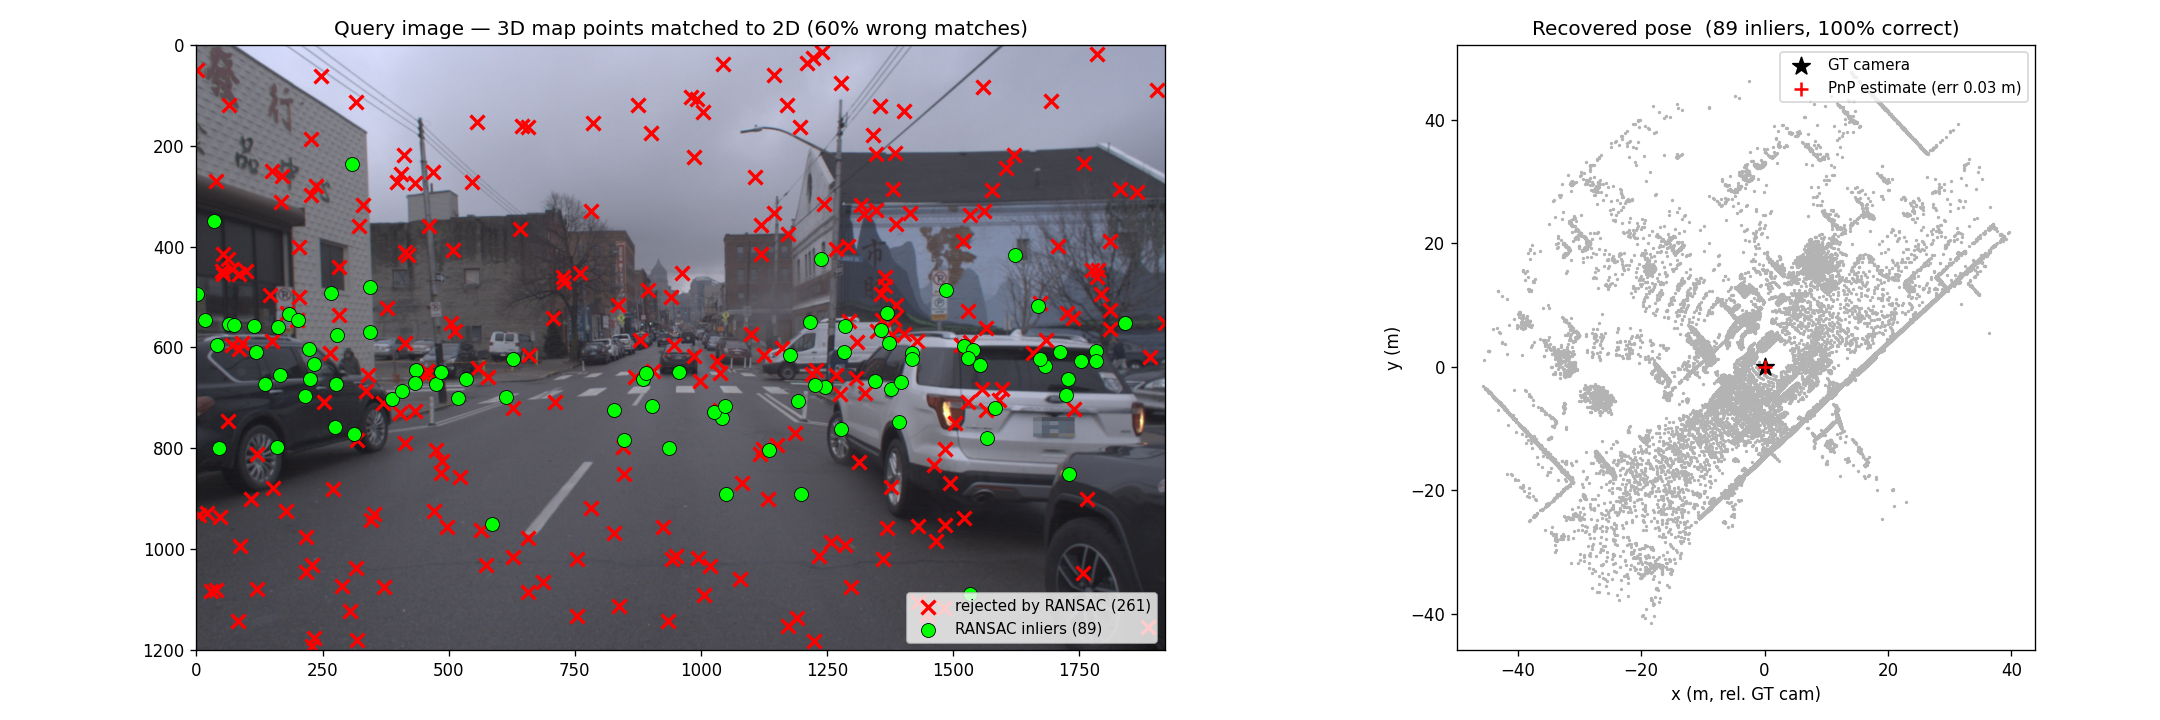
Mấu chốt: dù 60% dữ liệu là rác, PnP + RANSAC vẫn cho pose chính xác cỡ cm. Giống hỏi đường giữa đám đông — vài người chỉ bậy, mỗi người một kiểu (outlier ngẫu nhiên), nhưng những ai chỉ đúng đều trỏ về cùng một hướng; RANSAC chỉ việc tin vào nhóm đồng thuận đó. Các khớp đúng nhất quán hình học (cùng ủng hộ một pose), còn khớp sai rải rác nên vô hại.
Định vị theo bản đồ đường
Hướng thứ 4: không cần bản đồ đặc trưng dựng sẵn, chỉ cần road map miễn phí (OpenStreetMap) + ước lượng chuyển động tương đối từ VO. Một bộ lọc xác suất cập nhật khả năng xe đang ở từng đoạn đường: ban đầu mọi đoạn đều có khả năng như nhau, rồi mỗi lần xe rẽ là một lần lọc bớt — đoạn nào không thể rẽ kiểu đó thì giảm khả năng, đoạn nào khớp thì tăng.
Đây là định vị thật sự (không cần biết vị trí ban đầu), hội tụ sau ~30–40 giây ngay cả trên bản đồ rất lớn. Đổi lại, chỉ biết vị trí dọc đường, không phải pose 6DoF đầy đủ.
Tổng hợp: VO – SLAM – Localization
- VO — ước lượng chuyển động tương đối từ ảnh.
- SLAM — dựng bản đồ và định vị đồng thời; loop closure để bản đồ nhất quán.
- Localization — dùng bản đồ đó (hoặc road map / GPS / HD map) để tìm pose toàn cục.
Vài nguyên tắc:
- Phương pháp indirect (dùng feature) nhanh, hội tụ tốt nhưng kém chính xác hơn; direct chậm hơn nhưng chính xác hơn.
- Mapping có thể làm offline; nhưng localization phải real-time vì pose của ego phải có ngay cho các bước quyết định phía sau.
Triển khai thực tế: hợp nhất cảm biến
Không cảm biến nào hoàn hảo, nên hệ thật tích hợp GNSS, IMU, LiDAR, camera, radar, HD map — tận dụng điểm mạnh và bù điểm yếu của nhau. Mỗi nguồn bù đúng chỗ:
- RTK-GNSS — vị trí ~1–3 cm (so với ~1 m ở vi sai thường), nhưng vẫn rớt trong hầm/phố hẹp.
- IMU/INS — tần số cao, lấp khoảng giữa các lần cập nhật GNSS (5–10 Hz), nhưng trôi nếu thiếu GNSS lâu.
- LiDAR — mảnh ghép quyết định khi GNSS yếu: so khớp đám mây điểm quét được với bản đồ dựng sẵn (ví dụ bằng NDT).
- Camera — so khớp đặc trưng/làn đường với HD map (chính là ví dụ PnP ở trên).
- Wheel odometry — chuyển động tương đối, độc lập với cảnh bên ngoài.
Tóm lại: GNSS-RTK + IMU cho khung toàn cục thô, tần số cao; rồi LiDAR/camera đối sánh bản đồ (feature-based + map-based) để đạt độ chính xác cm và bền vững ở phố hẹp, hầm. Tất cả được hợp nhất bằng một bộ lọc trạng thái.
Xu hướng 2025–2026
- HD map + LiDAR (Waymo, Baidu Apollo, Mobileye): dựa nhiều vào HD map dựng sẵn ⇒ rất chính xác, nhưng đường ống sản xuất và bảo trì bản đồ đắt đỏ nên HD map chỉ phủ được một số khu vực.
- Mapless, vision-centric: kiến trúc mạng neuron xử lý camera + radar thời gian thực, không cần HD map hay LiDAR ⇒ rẻ, dễ mở rộng nhưng kém chính xác hơn.
- Lite map / crowdsourced và dựng HD map online (Mobileye): trung hoà giữa hai cực trên.