Visual Odometry
Visual Odometry (VO), SLAM và Localization là các phương pháp tập trung ước lượng chuyển động của chính xe (ego-motion). Thật vậy, để một chiếc xe tự lái được thì nó phải biết chuyển động của chính nó lẫn các phương tiện khác.
VO tập trung ước lượng chuyển động tương đối từ ảnh: tìm phép biến đổi vật rắn (rigid body) (R, t) với 6 bậc tự do giữa cảnh tại thời điểm t và t+1. Khác với định vị toàn cục, VO nối tiếp các pose và không cần bản đồ trước. Bản thân chữ VO trong tiếng Hy Lạp là sự kết hợp giữa hodos (route) + metron (measure).
Trong bài này ta triển khai toàn bộ quy trình Visual Odometry trên tập dữ liệu thực Argoverse 1.
Ký hiệu dùng trong bài
- ${}^{A}T_{B}$
- phép biến đổi SE(3) đưa điểm từ frame $B$ sang frame $A$ (= pose của $B$ trong $A$). Trong code:
A_SE3_B. - ${}^{A}R_{B}$, ${}^{A}t_{B}$
- phần rotation và translation của ${}^{A}T_{B}$.
- $K$, $E$, $F$
- nội tham số camera, essential matrix, fundamental matrix.
Mục lục
- Dữ liệu: một chuỗi ảnh từ Argoverse
- Ground truth: pose tương đối
- Chuyển sang hệ tọa độ camera
- VO: gán nhãn correspondence thủ công
- Fit epipolar geometry
- Khôi phục chuyển động tương đối
- Phụ lục: quy ước & tọa độ đồng nhất
Dữ liệu: một chuỗi ảnh từ Argoverse
Argoverse là tập dữ liệu lớn về xe tự hành. Ở đây ta chỉ dùng 2 ảnh từ camera trước, tải về từ Argoverse 1 (Training part 1 — mỗi part có nhiều log). Ảnh có kích thước 1920×1200 px ở 30 fps, và mỗi log đi kèm quỹ đạo của xe trong hệ tọa độ toàn cục (ví dụ hệ tọa độ thành phố).
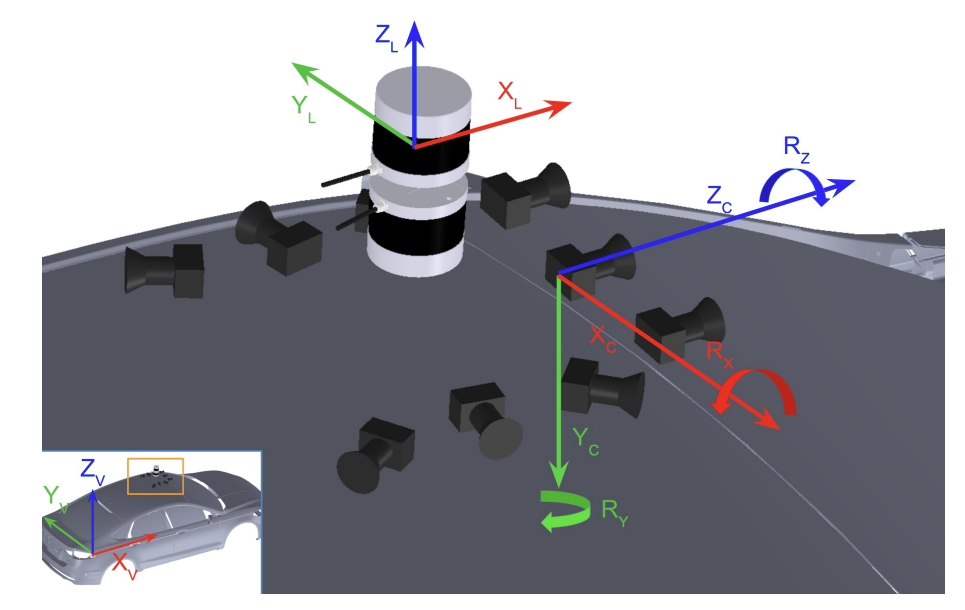
Bài toán: tái tạo lại quỹ đạo này chỉ dựa vào ảnh, qua các cặp điểm tương ứng 2D. Argoverse dùng quy ước hệ tọa độ sau: x hướng tới trước (hướng lái), y sang trái xe, z hướng lên (ngược trọng lực).
Ground truth: pose tương đối
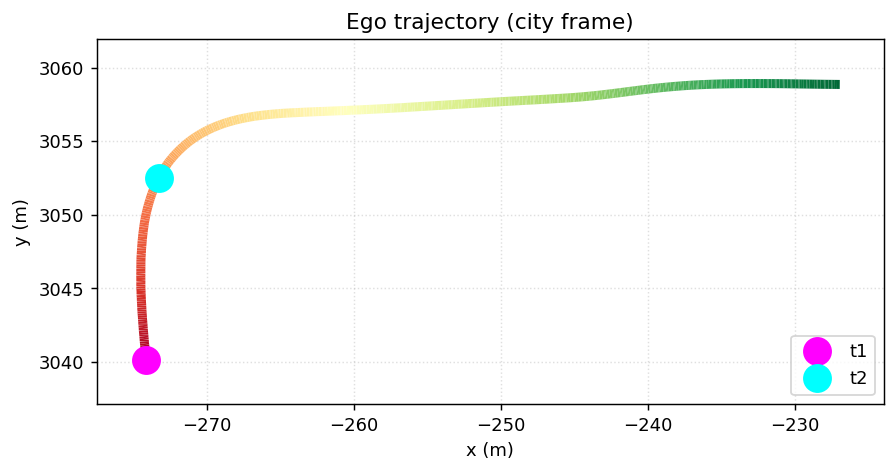
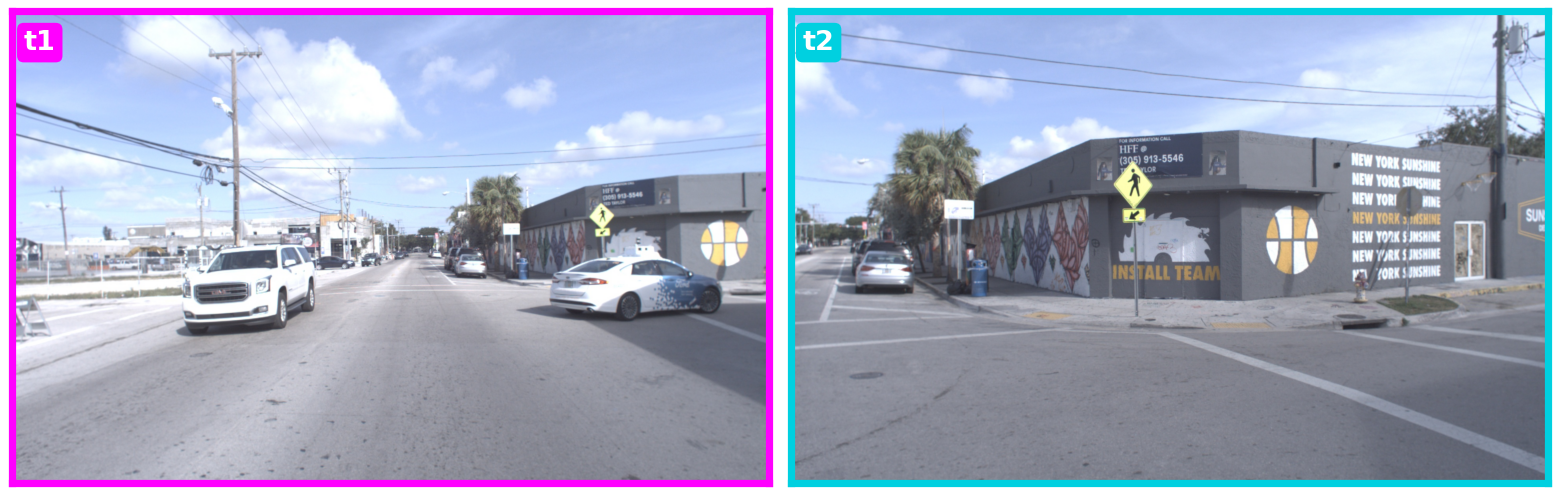
Để so sánh độ chính xác ta cần biết pose tương đối thực giữa hai thời điểm. Ta chọn 2 thời điểm trên quỹ đạo để lấy vị trí của xe (vị trí được đánh chỉ theo thời gian).
ts1 = 315975640448534784  # timestamp nano-giây
ts2 = 315975643412234000

log_id = '273c1883-673a-36bf-b124-88311b1a80be'
dataset_dir = '.../visual-odometry-tutorial/train1'

city_SE3_egot1 = get_city_SE3_egovehicle_at_sensor_t(ts1, dataset_dir, log_id)
city_SE3_egot2 = get_city_SE3_egovehicle_at_sensor_t(ts2, dataset_dir, log_id)

print(city_SE3_egot1.translation)   # vị trí ego tại t1 (hệ city)
print(city_SE3_egot2.translation)   # vị trí ego tại t2
[-274.08 3040.12  -19.03]
[-273.25 3052.5   -19.1 ]
Tại mỗi thời điểm, pose SE(3) chứa đồng thời rotation và translation:
- Translation — vị trí của pose so với hệ toàn cục,
- Rotation — hướng tại pose so với hệ toàn cục.
Ta muốn tìm pose tương đối giữa t1 và t2. Nghịch đảo pose đầu để đưa từ toàn cục về hệ t1, rồi compose:
# từ t1 về toàn cục
egot1_SE3_city = city_SE3_egot1.inverse()
# từ t1 đến t2
egot1_SE3_egot2 = egot1_SE3_city.compose(city_SE3_egot2)

from scipy.spatial.transform import Rotation
r = Rotation.from_matrix(egot1_SE3_egot2.rotation)
print(r.as_euler("zyx", degrees=True))        # yaw quanh trục z (hệ egovehicle)
print(np.round(egot1_SE3_egot2.translation, 2))
[-32.47   0.59  -0.44]
[12.27 -1.88  0.  ]
Trong hệ egovehicle, rotation tương đối là yaw ≈ −32.5° quanh trục z (xe rẽ phải), còn translation ≈ 12.3 m tiến (theo +x). Dấu âm/dương của góc sẽ đảo lại khi chuyển sang hệ camera ở mục sau.
Chuyển sang hệ tọa độ camera
Một điểm tinh tế nhưng quan trọng: thuật toán VO cho ra (R, t) giữa hai frame camera, chứ không phải giữa hai frame xe. Khi chạy eight-point trên các cặp điểm 2D, cái ta khôi phục được là ${}^{c1}R_{c2}$ và ${}^{c1}t_{c2}$ — chuyển động của camera giữa hai ảnh.
Vậy nên để kiểm tra VO đoán đúng hay không, phần ground truth (vốn đang ở ego frame) phải được chuyển sang đúng quy ước camera. Ta compose pose của xe với phép biến đổi ngoại (extrinsic) cố định ${}^{ego}T_{cam}$ đọc từ file calibration, để cả VO lẫn ground truth cùng nằm trong một hệ trước khi so sánh.
# egovehicle_SE3_camera: đọc từ vehicle_calibration_info.json
city_SE3_cam1 = city_SE3_egot1.compose(egovehicle_SE3_camera)
city_SE3_cam2 = city_SE3_egot2.compose(egovehicle_SE3_camera)
cam1_SE3_cam2 = city_SE3_cam1.inverse().compose(city_SE3_cam2)   # GROUND TRUTH (hệ camera)

gt_rot = Rotation.from_matrix(cam1_SE3_cam2.rotation).as_euler("zyx", degrees=True)
print("Ground truth rotation:", np.round(gt_rot, 3))
print("Ground truth t       :", np.round(cam1_SE3_cam2.translation, 2))
Ground truth rotation: [-0.371 32.475 -0.422]
Ground truth t       : [ 2.64 -0.03 12.05]
Đúng như phân tích: yaw đảo dấu thành +32.5° quanh trục y, và translation chủ yếu theo +z (camera tiến ~12 m về phía trước). Đây là cặp (R, t) mà VO sẽ cố khôi phục.
VO: gán nhãn correspondence thủ công
Để chạy VO, trước hết ta cần các cặp điểm tương ứng giữa hai ảnh. Các correspondence này có thể ước lượng bằng phương pháp cổ điển (DoG + SIFT + RANSAC) hay deep method (SuperPoint + SuperGlue). Trong ví dụ này ta gán nhãn thủ công bằng collect_ground_truth_corr.py: script dùng ginput() của matplotlib cho phép người dùng click các điểm trên mỗi ảnh rồi lưu correspondence ra file pickle.
export IMG_DIR=train1/273c1883-673a-36bf-b124-88311b1a80be/ring_front_center
python collect_ground_truth_corr.py \
  --img_fpath1 ${IMG_DIR}/ring_front_center_315975640448534784.jpg \
  --img_fpath2 ${IMG_DIR}/ring_front_center_315975643412234000.jpg \
  --experiment_name argoverse_2_E_1.pkl
Con người không thể hoàn hảo nên mỗi click đều có sai số đo. Do đó ta gán nhiều correspondence hơn mức tối thiểu để trung bình bớt nhiễu — ít nhất 5 điểm cho essential matrix và 8 điểm cho fundamental matrix. Ở cặp ảnh dưới, xe bắt đầu lái thẳng rồi rẽ phải; tuy nhiều vật thể động trong cảnh nhưng vẫn còn nhiều vật tĩnh để đối chiếu.
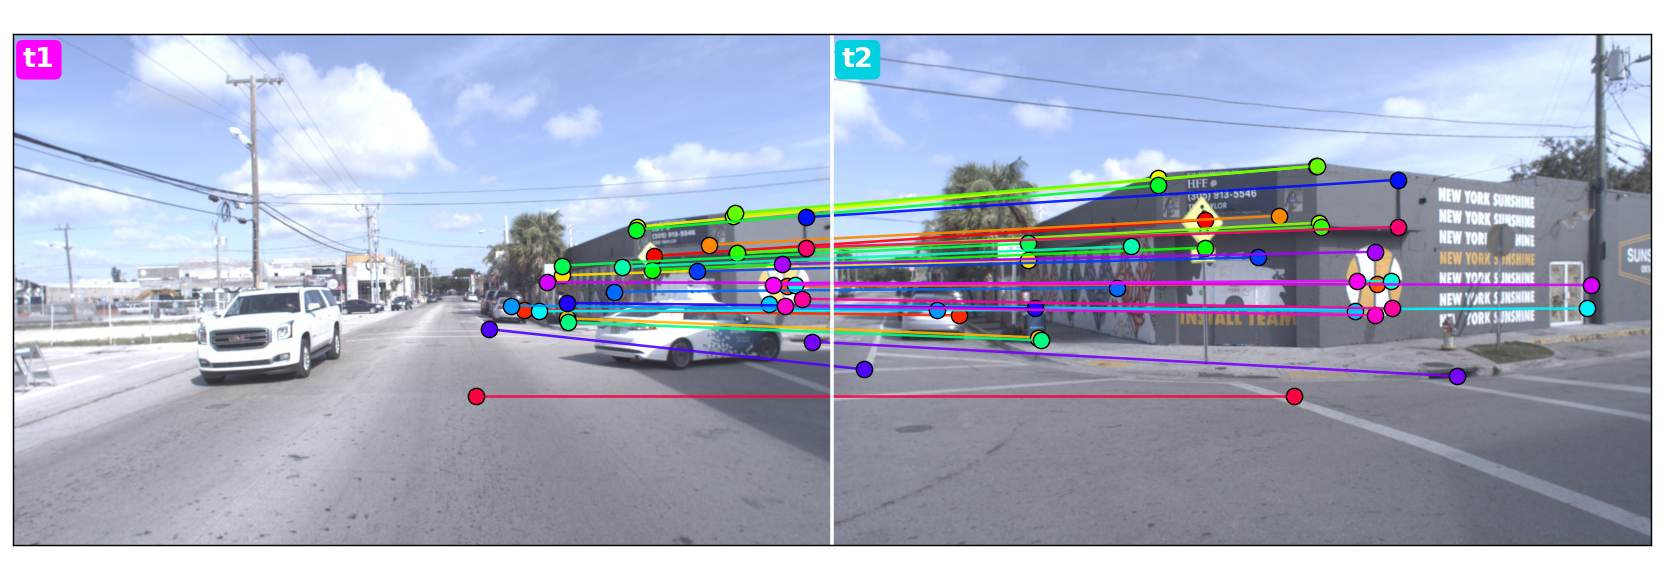
argoverse_2_E_1.pkl: mỗi đường nối một điểm trên ảnh t1 (trái) với điểm cùng vật thể trên ảnh t2 (phải), mỗi cặp một màu. Các điểm chủ yếu nằm trên vật tĩnh (toà nhà, cột, vạch kẻ đường).Fit epipolar geometry
Giờ ta fit quan hệ epipolar. Trước tiên đọc các điểm đã gán nhãn:
import pickle
import numpy as np

pkl_fpath = '.../labeled_correspondences/argoverse_2_E_1.pkl'
with open(pkl_fpath, 'rb') as f:
    d = pickle.load(f)

X1, Y1 = np.array(d['x1']), np.array(d['y1'])  # điểm trên ảnh 1
X2, Y2 = np.array(d['x2']), np.array(d['y2'])  # điểm trên ảnh 2

# hai mảng Nx2 cho các cặp điểm 2d-2d
img1_kpts = np.hstack([X1.reshape(-1,1), Y1.reshape(-1,1)]).astype(np.int32)
img2_kpts = np.hstack([X2.reshape(-1,1), Y2.reshape(-1,1)]).astype(np.int32)
Có hai ma trận liên quan. Fundamental matrix $F$ liên hệ các điểm ở tọa độ pixel, không cần biết camera. Essential matrix $E$ liên hệ các điểm ở tọa độ chuẩn hóa nên cần nội tham số $K$. Quan hệ: $F = K^{-T} E K^{-1}$:
def get_fmat_from_emat(i2_E_i1, K1, K2):
    i2_F_i1 = np.linalg.inv(K2).T @ i2_E_i1 @ np.linalg.inv(K1)
    return i2_F_i1
Vì camera ở hai pose giống nhau nên $K$ không đổi. Ta ước lượng $E$ bằng OpenCV, dùng RANSAC để loại outlier:
import cv2
K = calib_dict['ring_front_center'].K[:3, :3]

cam2_E_cam1, inlier_mask = cv2.findEssentialMat(
    img1_kpts, img2_kpts, K, method=cv2.RANSAC, threshold=0.1)
print('Num inliers:', inlier_mask.sum())

cam2_F_cam1 = get_fmat_from_emat(cam2_E_cam1, K1=K, K2=K)
draw_epilines(img1_kpts, img2_kpts, img1, img2, cam2_F_cam1)
Num inliers: 9
(9 trên 33 điểm click tay được giữ lại sau RANSAC — phần còn lại bị loại do nhiễu khi click.)
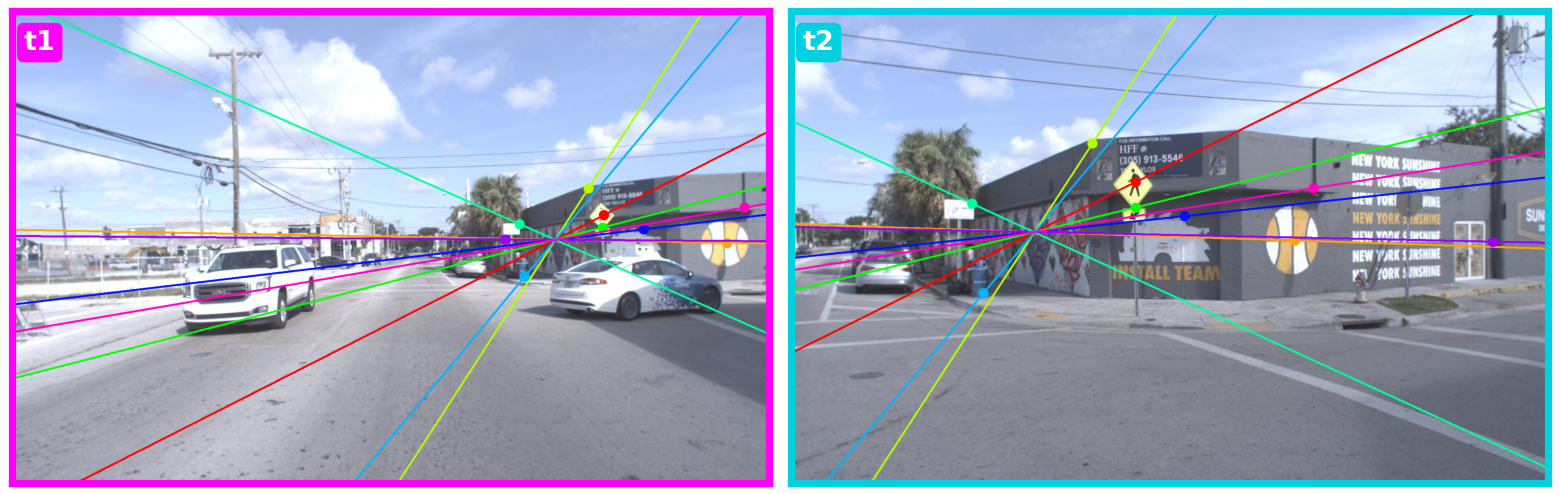
Một cách kiểm tra trực quan là vẽ các đường epipolar. Một điểm ở ảnh này tương ứng với một đường thẳng 1D ở ảnh kia, và mọi đường epipolar hội tụ tại epipole. Hãy để ý vị trí epipole ở ảnh trái: đó chính là nơi camera trước sẽ nằm khi ảnh thứ hai được chụp. Dùng mỗi màu cho một correspondence, mọi điểm sẽ nằm trên đường epipolar của nó.
Khôi phục chuyển động tương đối
Cuối cùng ta phân tích essential matrix ra rotation và translation. OpenCV dùng thuật toán 5-point bên trong:
_num_inlier, cam2_R_cam1, cam2_t_cam1, _ = cv2.recoverPose(
    cam2_E_cam1, img1_kpts, img2_kpts, K, mask=inlier_mask)

print(Rotation.from_matrix(cam2_R_cam1).as_euler('zyx', degrees=True))
print(np.round(cam2_t_cam1.squeeze(), 2))
[  0.4  -30.53   0.91]
[ 0.25  0.03 -0.97]
Có một vấn đề. Rotation tương đối thu được là −30.5° chứ không phải +32° như mong đợi, và translation hướng về −z thay vì +z. Lý do là recoverPose trả về phép biến đổi nghịch đảo (${}^{c2}R_{c1}$ thay vì ${}^{c1}R_{c2}$). Nghịch đảo nó lại rồi so trực tiếp với ground truth:
# đảo ngược cam2_T_cam1 -> cam1_T_cam2, rồi so với ground truth
cam1_SE3_cam2_est = SE3(cam2_R_cam1, cam2_t_cam1.squeeze()).inverse()
est_rot = Rotation.from_matrix(cam1_SE3_cam2_est.rotation).as_euler("zyx", degrees=True)
est_t_unit = cam1_SE3_cam2_est.translation / np.linalg.norm(cam1_SE3_cam2_est.translation)
gt_t_unit = cam1_SE3_cam2.translation / np.linalg.norm(cam1_SE3_cam2.translation)

print("Ước lượng rotation:", np.round(est_rot, 2))
print("Ground truth      :", np.round(gt_rot, 2))
print("Ước lượng t (unit):", np.round(est_t_unit, 3))
print("Ground truth t    :", np.round(gt_t_unit, 3))
Ước lượng rotation: [ 0.08 30.54 -0.83]
Ground truth      : [-0.37 32.47 -0.42]
Ước lượng t (unit): [ 0.274 -0.015  0.962]
Ground truth t    : [ 0.214 -0.002  0.977]
Sau khi đảo ngược, yaw ≈ +30.5° (ground truth +32.5°) và hướng translation lệch chỉ ~3.6° so với ground truth — khá tốt với pose click tay. VO chỉ khôi phục được hướng translation, không có tỉ lệ (gauge ambiguity), nên ta so vector đơn vị.
Phụ lục: quy ước & tọa độ đồng nhất
1. Ký hiệu. ${}^{A}T_{B}$ (viết A_SE3_B trong code) là phép biến đổi đưa điểm từ hệ $B$ sang hệ $A$ — chính là pose của $B$ trong hệ $A$.
2. Compose. Compose hai phép SE(3) chính là nhân hai ma trận 4×4, nên ${}^{A}T_{C} = {}^{A}T_{B} \cdot {}^{B}T_{C}$ (trong code, A_SE3_C = A_SE3_B.compose(B_SE3_C)).
3. Tại sao cần tọa độ đồng nhất (homogeneous)? Phép tịnh tiến không phải phép tuyến tính, trong khi một phép SE(3) gồm xoay rồi mới tịnh tiến. Nếu chỉ dùng vector 3 chiều, bạn không thể gộp xoay và tịnh tiến vào một phép nhân ma trận duy nhất — mỗi lần phải nhân $R$ rồi cộng $t$ riêng, rất rối khi compose nhiều bước.
Tọa độ đồng nhất giải quyết bằng cách thêm một chiều: nâng điểm $p$ lên vector 4 chiều bằng cách thêm số 1, rồi nhét $R$ và $t$ vào một ma trận 4×4 duy nhất. Một phép nhân giờ làm được cả hai việc. Nó cũng xử lý phép chiếu: camera chiếu điểm 3D xuống ảnh 2D bằng cách chia cho độ sâu $Z$, mà phép chia này không tuyến tính — nhưng quy ước đồng nhất xử lý gọn gàng.