SLAM & Bundle Adjustment
Ở bài Visual Odometry, ta khôi phục chuyển động tương đối (R, t) giữa hai frame camera từ các cặp điểm tương ứng. Ghép nhiều cặp liên tiếp lại thì dựng được cả quỹ đạo. Nhưng mỗi bước đều có một sai số nhỏ, và các sai số ấy cộng dồn qua thời gian (drift). SLAM giải quyết drift bằng cách không tối ưu từng bước riêng lẻ nữa, mà tối ưu đồng thời tất cả pose camera và tất cả điểm 3D trong một bài toán duy nhất.
SLAM = Simultaneous Localization And Mapping: cùng lúc ước lượng vị trí camera (localization) và bản đồ điểm (mapping). Tương tự VO, khi đã có các điểm tương ứng giữa các ảnh (correspondence), ta chiếu mỗi điểm 3D vào từng camera, tính sai lệch so với vị trí đo được, rồi điều chỉnh đồng thời vị trí camera lẫn vị trí điểm sao cho tổng sai lệch nhỏ nhất. Đó chính là Bundle Adjustment (BA) — một bài bình phương tối thiểu. Vì residual phi tuyến (phép chiếu, khoảng cách), ta giải lặp bằng Gauss–Newton; và vì số điểm rất lớn (hàng vạn trong bài toán xe tự lái), mỗi vòng lặp sinh ra một hệ tuyến tính khổng lồ — giải hiệu quả nhờ Schur complement.
Trong bài này ta xây BA từ đầu qua 2 ví dụ: một bài 1D tuyến tính để kiểm chứng công thức bằng tay, rồi một bài trên quỹ đạo xe thật của Argoverse (cùng tập dữ liệu đã dùng ở bài VO) — khép lại bằng việc dựng bản đồ lidar thật từ quỹ đạo đã tối ưu.
Ký hiệu dùng trong bài
- $c$, $p$
- biến camera (pose) và biến điểm/landmark cần tối ưu.
- $r$, $J$
- residual (sai khác giữa dự đoán và đo) và Jacobian $\partial r/\partial$ biến.
- $H$, $g$
- xấp xỉ Hessian $H = J^\top J$ và gradient $g = J^\top r$.
- $U$, $V$, $W$
- khối camera–camera, điểm–điểm, và camera–điểm của $H$.
- $S$
- Schur complement (hệ rút gọn chỉ còn biến camera).
Mục lục
- Từ Visual Odometry đến SLAM
- Bài toán: bình phương tối thiểu phi tuyến
- Cấu trúc khối của Hessian & Schur complement
- Ví dụ 1 — tuyến tính 1D, đối chiếu tính tay
- Ví dụ 2 — quỹ đạo Argoverse thật
- Từ quỹ đạo đến bản đồ lidar
- Phụ lục: Gauss–Newton, damping, gauge & observability
Từ Visual Odometry đến SLAM
Bài VO dừng ở chỗ: từ một cặp ảnh và các correspondence, cv2.recoverPose cho ta (R, t) giữa hai camera. Đó là một phép đo tương đối, và nó có hai hạn chế:
- Drift — ghép nhiều
(R, t)liên tiếp thì sai số tích lũy, quỹ đạo lệch dần. - Chưa dùng hết ràng buộc — một điểm 3D thường được nhìn từ nhiều hơn hai camera. VO hai-view bỏ phí thông tin đó.
SLAM/BA giải cả hai bằng cách đặt một bài tối ưu trên toàn bộ: mỗi điểm 3D $p_j$ nhìn từ camera $c_i$ sinh ra một residual (sai khác giữa vị trí đo được và vị trí dự đoán khi chiếu điểm qua camera). Mục tiêu: chỉnh đồng thời mọi $c_i$ và $p_j$ để tổng bình phương residual nhỏ nhất.
Mối liên hệ. Correspondence (các cặp điểm) mà ta gán nhãn ở phần VO chính là đầu vào của BA. VO cho điểm khởi tạo tốt; BA tinh chỉnh nó bằng cách dùng mọi quan sát cùng lúc.
Bài toán: bình phương tối thiểu phi tuyến
Gọi $x$ là toàn bộ ẩn số (vị trí mọi camera — pose — và vị trí mọi điểm quan sát được từ camera — points). Ta cực tiểu hóa:
\[E(x) = \sum_k \lVert r_k(x) \rVert^2\]Vì $r_k$ phi tuyến (phép chiếu, hoặc tính khoảng cách giữa hai điểm — l2 norm), ta tuyến tính hóa quanh nghiệm hiện tại: $r(x+\delta) \approx r(x) + J\delta$, rồi giải bước cập nhật $\delta$ bằng phương trình chuẩn (normal equations):
$H\delta = -g$, với $H = J^\top J$, $g = J^\top r$
Đây là Gauss–Newton: $H = J^\top J$ là xấp xỉ Hessian (bỏ qua đạo hàm bậc hai của $r$), đủ tốt khi residual nhỏ. Lặp lại đến khi hội tụ.
Nói cách khác: tuyến tính hóa hàm mục tiêu tại vị trí ban đầu, giải bước cập nhật bằng cách cho đạo hàm bằng 0, cập nhật nghiệm tới vị trí tối ưu trong vùng tuyến tính hóa đó, rồi tiếp tục tuyến tính hóa quanh nghiệm mới và giải lại — lặp đến khi nghiệm gần như không đổi.
Nếu dựng thẳng $H$ đầy đủ rồi giải, chi phí là $O(n^3)$ với $n$ = tổng số ẩn — bất khả thi khi có hàng nghìn điểm. Đây là lúc cấu trúc khối vào cuộc.
Cấu trúc khối của Hessian & Schur complement
Tách ẩn số làm hai nhóm — camera (c) và điểm (p) — thì $H$ có dạng mũi tên (arrowhead):
- $U$ — khối camera–camera (nhỏ, cỡ số camera).
- $V$ — khối điểm–điểm, block-diagonal: mỗi điểm độc lập với điểm khác ⇒ đảo cực rẻ.
- $W$ — khối liên kết camera–điểm (thưa: chỉ khác 0 khi camera $i$ thấy điểm $j$).
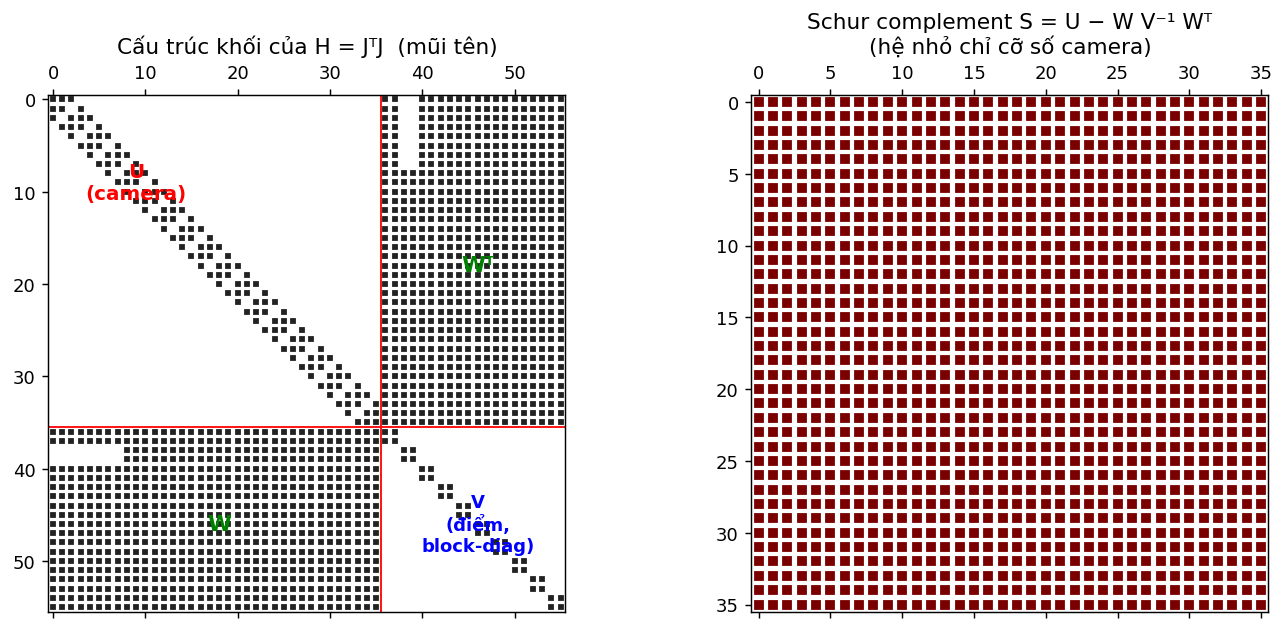
Schur complement khai thác đúng cấu trúc này, tách $H\delta = -g$ thành 4 bước (chính là cách COLMAP, g2o, Ceres làm bên trong):
1. $V^{-1}$ (rẻ vì block-diagonal)
2. $S = U - W V^{-1} W^\top$ (Schur complement)
3. giải $\delta_c$: $S\,\delta_c = -(g_c - W V^{-1} g_p)$
4. thế ngược: $\delta_p = -V^{-1}(g_p + W^\top \delta_c)$
Mấu chốt: ta chỉ phải giải hệ $S$ cỡ số camera (vài chục) thay vì cả $H$ cỡ số-camera-cộng-số-điểm (hàng nghìn). Toàn bộ phần còn lại của bài chỉ là lắp $U, V, W, g_c, g_p$ từ Jacobian rồi gọi hàm này:
import numpy as np

def solve_schur(U, W, V, gc, gp, lam=0.0):
    U = U + lam*np.eye(U.shape[0])      # damping Levenberg–Marquardt (xem phụ lục)
    V = V + lam*np.eye(V.shape[0])
    Vinv = np.linalg.inv(V)             # 1) đảo V (block-diagonal -> rẻ)
    S  = U - W @ Vinv @ W.T             # 2) Schur complement
    dc = np.linalg.solve(S, -(gc - W @ Vinv @ gp))   # 3) giải delta_c
    dp = -Vinv @ (gp + W.T @ dc)        # 4) thế ngược ra delta_p
    return dc, dp, S
Ví dụ 1 — tuyến tính 1D, đối chiếu tính tay
Bắt đầu bằng mô hình đơn giản nhất để kiểm chứng công thức: mọi thứ nằm trên một trục.
- 2 camera $c_0, c_1$; 3 điểm $p_0, p_1, p_2$.
- Mỗi quan sát đo “khoảng cách” $m = p_j - c_i$ ⇒ residual $r = (p_j - c_i) - m$, nên $\partial r/\partial c_i = -1$, $\partial r/\partial p_j = +1$.
- Thêm 1 prior ghim cứng $c_0$ để cố định gauge (xem phụ lục).
Vì mô hình tuyến tính, Gauss–Newton hội tụ trong đúng 1 bước:
cams_gt = np.array([1.0, 2.0])
pts_gt  = np.array([3.0, 7.0, 10.0])
obs = [(0,0),(0,1),(1,1),(1,2)]              # cam0 thấy p0,p1 ; cam1 thấy p1,p2
m = np.array([pts_gt[j]-cams_gt[i] for i,j in obs])

c = np.array([0.0, 0.0]); P = np.array([0.0, 0.0, 0.0])    # init lệch khỏi nghiệm
nc, npt = 2, 3
U=np.zeros((nc,nc)); V=np.zeros((npt,npt)); W=np.zeros((nc,npt))
gc=np.zeros(nc); gp=np.zeros(npt)
for (i,j),mij in zip(obs,m):
    r=(P[j]-c[i])-mij; Jc,Jp=-1.0,1.0
    U[i,i]+=Jc*Jc; V[j,j]+=Jp*Jp; W[i,j]+=Jc*Jp     # dồn J^T J vào đúng khối
    gc[i]+=Jc*r;   gp[j]+=Jp*r
r=(c[0]-cams_gt[0]); U[0,0]+=1; gc[0]+=r            # prior cố định cam0

dc,dp,S = solve_schur(U,W,V,gc,gp)
# S       -> [[ 1.5 -0.5]   <-- khớp đúng kết quả tính tay
#             [-0.5  0.5]]
# c+dc    -> [1. 2.]   (= cams_gt)
# P+dp    -> [ 3.  7. 10.]   (= pts_gt)

# Kiểm chứng: Schur cho kết quả Y HỆT giải thẳng cả ma trận H đầy đủ
H=np.block([[U,W],[W.T,V]]); g=np.concatenate([gc,gp])
full=np.linalg.solve(H,-g)
# np.allclose(np.concatenate([dc,dp]), full) -> True
Hai điều cần nắm: (1) $S$ ra đúng $\begin{bmatrix} 1.5 & -0.5 \ -0.5 & 0.5 \end{bmatrix}$ như khi tính tay; (2) giải Schur bằng giải thẳng cả $H$ — Schur chỉ là cách giải nhanh hơn, không đổi nghiệm.
Ví dụ 2 — quỹ đạo Argoverse thật
Giờ chạy trên dữ liệu thật. Ta đọc trực tiếp các file pose city_SE3_egovehicle_*.json của một log Argoverse 1 — cùng tập dữ liệu đã dùng ở bài VO — và lấy vị trí xe $(x, y)$ làm ground-truth trajectory.
Khác Ví dụ 1 (tuyến tính, giải 1 phát), phép đo ở đây là khoảng cách Euclid nên residual phi tuyến ⇒ $J, r$ phải tính lại mỗi vòng lặp Gauss–Newton. Cách dồn vào $U, V, W$ thì y hệt — và solve_schur vẫn không đổi một dòng.
import json, glob, os
LOG = "data/.../train1/e17eed4f-3ffd-3532-ab89-41a3f24cf226"
pf = sorted(glob.glob(os.path.join(LOG,"poses","city_SE3_egovehicle_*.json")),
            key=lambda p:int(p.split("_")[-1].split(".")[0]))
xy = np.array([json.load(open(p))["translation"][:2] for p in pf])
gt = xy[::40][:18]; gt = gt - gt[0]          # mỗi 40 frame, 18 pose, recenter về gốc
N = len(gt)
# N = 18 ; span ~ 18.6 x 17.2 m  (một đoạn xe đang rẽ)
Trên quỹ đạo đó ta dựng một bài SLAM 2D — đây là chỗ các mảnh ghép nối lại:
- Camera = vị trí xe tại mỗi mốc thời gian (ẩn số 2D cần tìm) — tương tự pose trong VO.
- Landmark = vài điểm mốc rải quanh đường (mô phỏng cột đèn/biển báo mà lidar bắt được).
- Quan sát range: mỗi pose đo khoảng cách tới landmark trong bán kính 40 m (có nhiễu) — vai trò như correspondence trong VO.
- Odometry: chuyển vị tương đối giữa 2 pose liền kề (có nhiễu) — chính là $(R, t)$ mà VO sản ra; nó tạo ràng buộc camera–camera (dải chéo trong khối $U$ ở hình trên).
- Prior: cố định pose0 (gauge) + prior lỏng landmark khử nhập nhằng range-only.
Khởi tạo bằng dead-reckoning (cộng dồn odometry nhiễu) → quỹ đạo trôi dần; rồi BA dùng range tới landmark kéo về gần ground-truth. Đây đúng là lý do cần SLAM: odometry một mình thì drift, bản đồ landmark sửa lại.
rng = np.random.default_rng(0)
mn, mx = gt.min(0)-15, gt.max(0)+15
L_gt = rng.uniform(mn, mx, size=(10,2)); M = len(L_gt)
obs = [(i,l, np.hypot(*(L_gt[l]-gt[i])) + rng.normal(0,0.15))    # range có nhiễu
       for i in range(N) for l in range(M) if np.hypot(*(L_gt[l]-gt[i])) < 40]
odo = [(i, gt[i+1]-gt[i] + rng.normal(0,0.7,2)) for i in range(N-1)]   # odometry trôi
# n range obs = 176 ; n odo = 17

x = np.zeros((N,2))                              # init = dead-reckoning
for i,o in odo: x[i+1] = x[i] + o
x_dr = x.copy()
L_prior = L_gt + rng.normal(0,3,size=L_gt.shape); Lh = L_prior.copy()
wp, wl = 10.0, 0.6                               # trọng số prior pose0 / landmark
ci = lambda i: slice(2*i,2*i+2); li = lambda l: slice(2*l,2*l+2)

for it in range(30):
    U=np.zeros((2*N,2*N)); V=np.zeros((2*M,2*M)); W=np.zeros((2*N,2*M))
    gc=np.zeros(2*N); gp=np.zeros(2*M); cost=0.0
    for i,l,z in obs:                            # --- residual range (camera <-> điểm) ---
        dvec=Lh[l]-x[i]; d=np.hypot(*dvec)+1e-9; r=d-z; cost+=r*r
        Jx=-dvec/d; JL=dvec/d
        U[ci(i),ci(i)]+=np.outer(Jx,Jx); gc[ci(i)]+=Jx*r
        V[li(l),li(l)]+=np.outer(JL,JL); gp[li(l)]+=JL*r; W[ci(i),li(l)]+=np.outer(Jx,JL)
    for i,o in odo:                              # --- residual odometry (camera <-> camera) ---
        r=(x[i+1]-x[i])-o; cost+=r@r; I=np.eye(2)
        U[ci(i),ci(i)]+=I; U[ci(i+1),ci(i+1)]+=I
        U[ci(i),ci(i+1)]-=I; U[ci(i+1),ci(i)]-=I
        gc[ci(i)]+=-r; gc[ci(i+1)]+=r
    r=wp*x[0]; U[ci(0),ci(0)]+=wp*wp*np.eye(2); gc[ci(0)]+=wp*r; cost+=r@r   # gauge
    for l in range(M):                           # prior lỏng landmark
        rl=wl*(Lh[l]-L_prior[l]); V[li(l),li(l)]+=wl*wl*np.eye(2); gp[li(l)]+=wl*rl; cost+=rl@rl
    dc,dp,_=solve_schur(U,W,V,gc,gp,lam=1e-2)    # <-- vẫn đúng hàm ở Ví dụ 1
    x=x+dc.reshape(-1,2); Lh=Lh+dp.reshape(-1,2)
# cost: 4668 -> 119 (sàn = nhiễu đo) sau ~3 vòng
# Sai số quỹ đạo (RMSE so với ground-truth):
#   dead-reckoning = 3.709 m   ->   sau BA = 1.478 m   (giảm 2.5x)
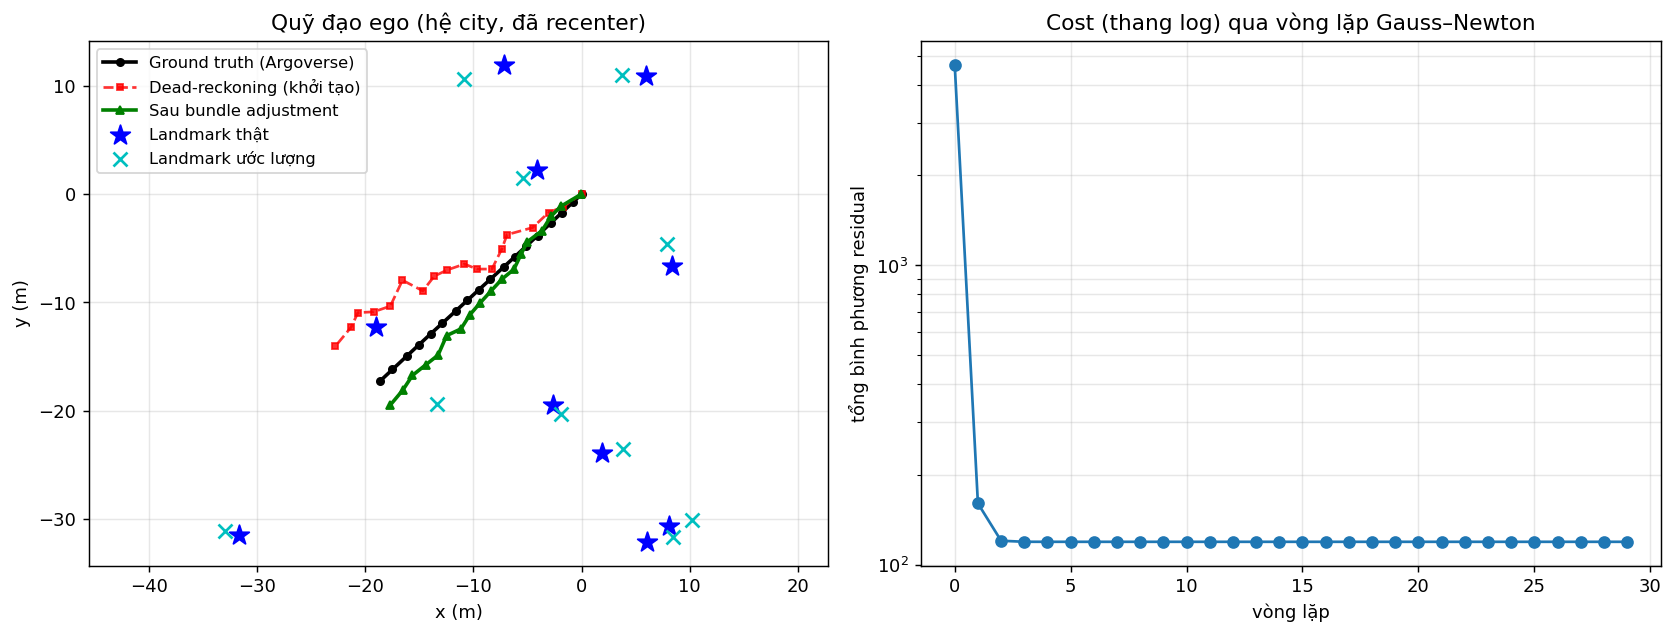
Điểm đáng chú ý: hàm solve_schur ở Ví dụ 1 không đổi một dòng — từ bài 1D tính tay đến SLAM trên xe thật, chỉ có cách lắp $U, V, W$ là khác. Đó chính là sức mạnh của việc tách bài toán theo cấu trúc khối.
Từ quỹ đạo đến bản đồ lidar
Tới đây ta mới làm xong nửa “L” (localization — quỹ đạo). Nửa còn lại, “M” (mapping), gần như miễn phí: có quỹ đạo tốt rồi thì chỉ việc lấy point cloud lidar ở mỗi pose (đang ở hệ xe) và đặt nó vào một hệ chung bằng chính pose đó — các sweep chồng lên nhau sẽ cộng hưởng thành bản đồ.
Một điểm khác nhỏ: lidar cần cả hướng xe, nên ở đây pose là SE(2) $(x, y, \theta)$ — thêm góc $\theta$ so với bài range-only phía trên. Bộ máy Gauss–Newton + Schur y nguyên, residual chỉ thêm thành phần góc (code đầy đủ trong notebook). Hàm gom bản đồ gọn lại chỉ còn xoay theo $\theta$ rồi tịnh tiến:
def aggregate(poses, sweeps):       # poses: (N,3) = (x, y, theta) ; sweeps[i]: điểm lidar hệ xe
    pts = []
    for (x, y, th), p_ego in zip(poses, sweeps):
        c, s = np.cos(th), np.sin(th)
        X = c*p_ego[:,0] - s*p_ego[:,1] + x        # xoay theo yaw + tịnh tiến -> hệ map
        Y = s*p_ego[:,0] + c*p_ego[:,1] + y
        pts.append(np.c_[X, Y])
    return np.concatenate(pts)
# RMSE quỹ đạo:  dead-reckoning = 2.85 m   ->   sau BA = 0.11 m   (78 sweep, ~1.7M điểm)
Cùng một bộ lidar sweep, đặt theo ba quỹ đạo khác nhau:
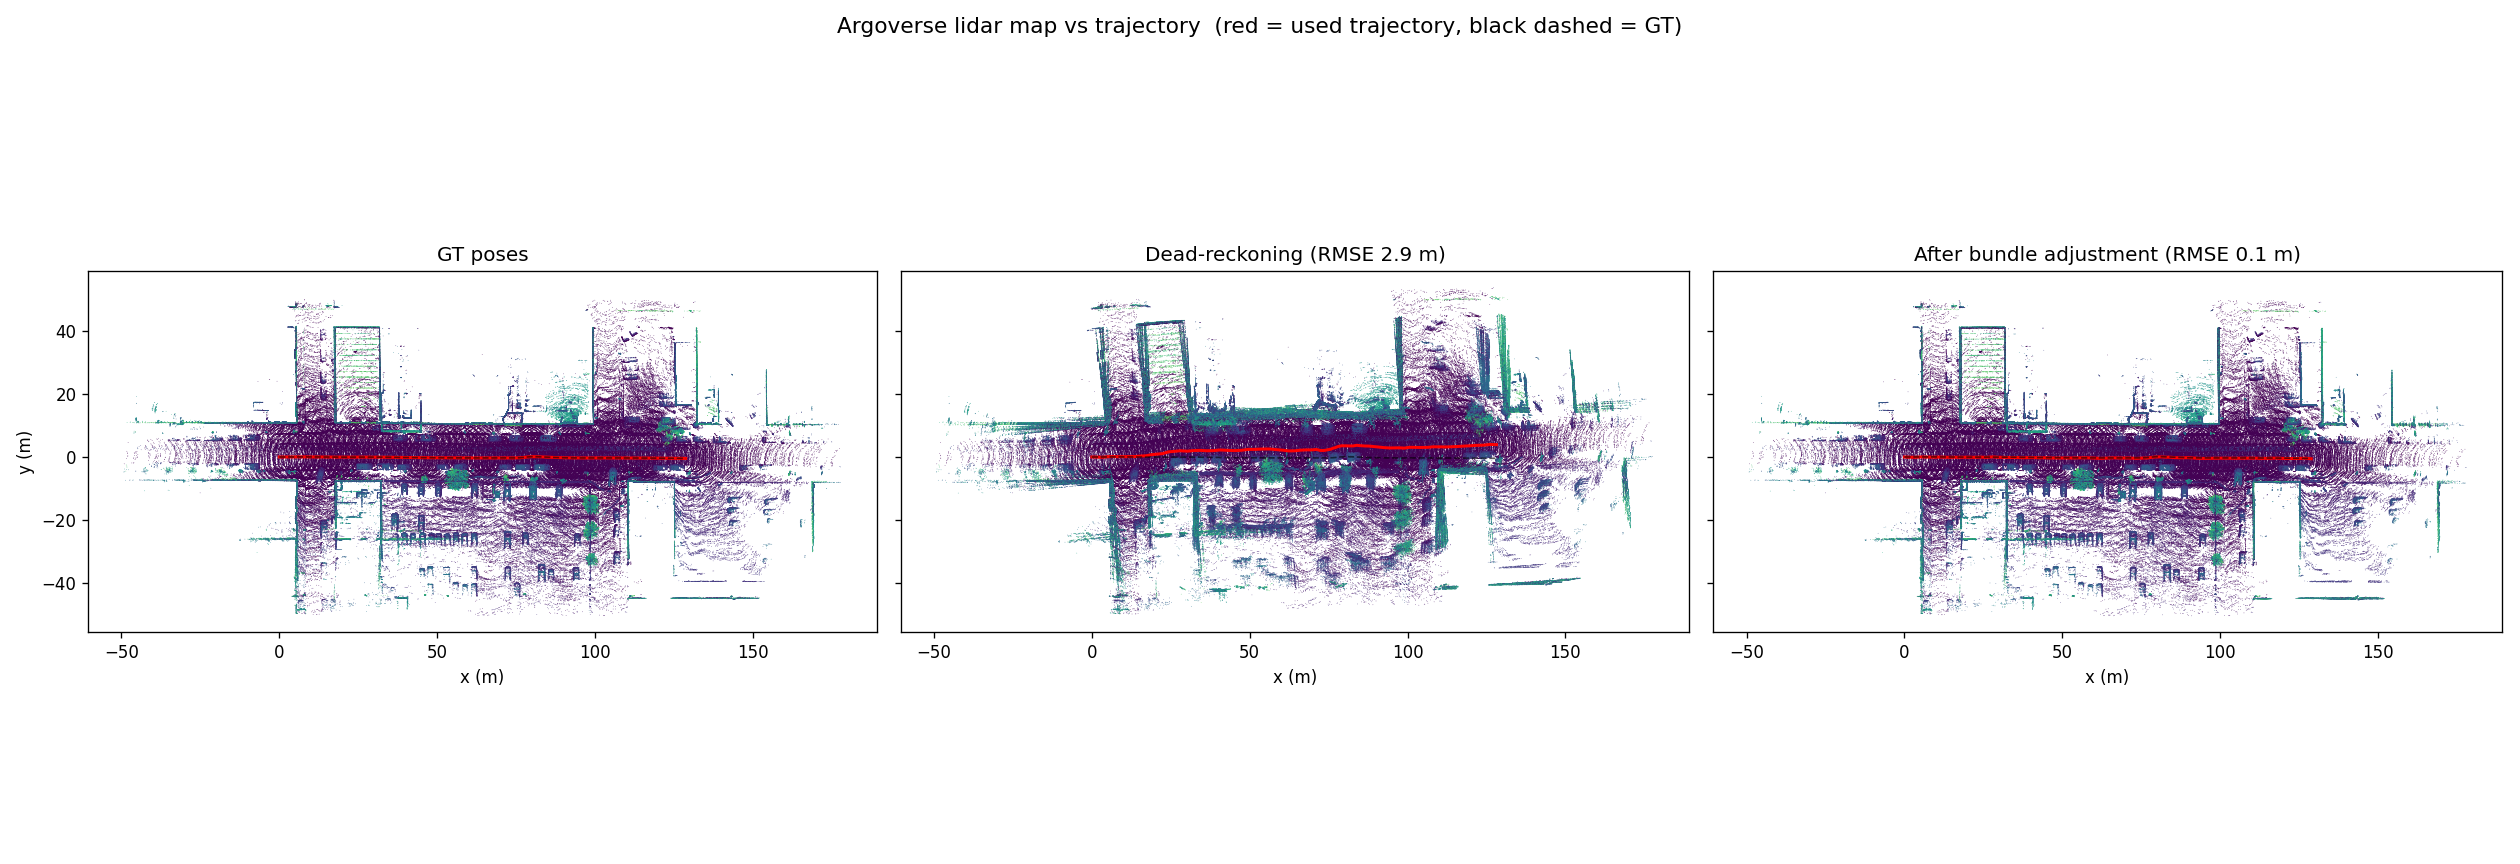
Đây là lý do trực quan nhất cho thấy vì sao cần SLAM: pose tốt ⇒ bản đồ sắc. Drift làm các sweep lệch nhau nên cùng một bức tường bị vẽ thành nhiều lớp; BA chỉnh lại pose nên các lớp đó chồng khít. Bước tiếp theo để thành SLAM hoàn chỉnh là loop closure (phát hiện đi qua chỗ cũ) — thêm ràng buộc camera–camera ở xa nhau, vẫn nằm gọn trong khối $U$ và cùng solve_schur này.
Phụ lục: Gauss–Newton, damping, gauge & observability
1. Gauss–Newton vs Levenberg–Marquardt. Ta xấp xỉ Hessian bằng $J^\top J$ (bỏ số hạng bậc hai). Khi xa nghiệm hoặc $S$ gần suy biến, bước Gauss–Newton có thể “nhảy” hỏng. Tham số lam trong solve_schur cộng nhẹ $\lambda I$ vào đường chéo — đó là damping Levenberg–Marquardt: $\lambda$ lớn → bước nhỏ, thận trọng (giống gradient descent); $\lambda$ nhỏ → bước Gauss–Newton nhanh.
2. Gauge freedom. Nếu dịch chuyển toàn bộ cảnh (mọi camera và điểm) đi cùng một lượng, mọi khoảng cách/quan sát tương đối không đổi ⇒ cost không đổi ⇒ bài toán có vô số nghiệm. Đây là gauge freedom. Ta khử bằng một prior cố định một mốc (pose0 ở Ví dụ 2). Hiện tượng này họ hàng với scale ambiguity ở bài VO: ở đó VO chỉ khôi phục được hướng translation chứ không có tỉ lệ, nên phải so vector đơn vị.
3. Observability (nhập nhằng range-only). Với phép đo chỉ khoảng cách, một landmark và ảnh phản chiếu của nó qua đường đi cho cùng bộ khoảng cách ⇒ cost = 0 cho nhiều cảnh khác nhau. Bỏ hết prior thì BA có thể hội tụ về một cảnh “đúng số nhưng sai hình”. Prior lỏng (w_prior, wl) và việc tăng độ phủ quan sát giúp bài toán well-posed. Đây là vấn đề observability thật của SLAM, không phải lỗi code.
4. Muốn thử thêm. Bớt obs (bài kém ràng buộc), tăng nhiễu range/odo, tăng lam (bước thận trọng hơn), hoặc bỏ prior để thấy range-only nhập nhằng. Bước tiếp theo để sát BA thật trong COLMAP/VO: thay residual khoảng cách bằng reprojection error (sai số pixel khi chiếu điểm 3D qua camera) — đúng mô hình mà bài Visual Odometry đã dựng nền.